现如今各种大模型早已“飞入寻常百姓家”,国内的豆包、kimi、deep seek,国外的gpt、Gemini等模型堪称琳琅满目。但是不知道大家在日常的使用中有没有想过,你输入的一段文字是怎么变成和输入截然不同的输出返回给你的?
之前的文章里已经提到了大模DAMOC 型基本都是基于Transformer架构构建的,其基本原理是先把输入字符串转换成一个向量序列,计算出一个概率分布,最后在概率分布中进行随机采样,期间会有一批参数影响最终的概率分布,这样就完成了一个字符的生成。把生成的字符拼接到输入的末尾,重复上述操作,就能完成一段文字的生成。
但是,模型计费用的不是Tokens吗,这个过程里怎么全程没有看到Tokens这个词呢?为什么不直接用字符而是要转换成向量呢?向量为什么可以生成句子呢?本篇我们就来一一解决这些遗留问题。
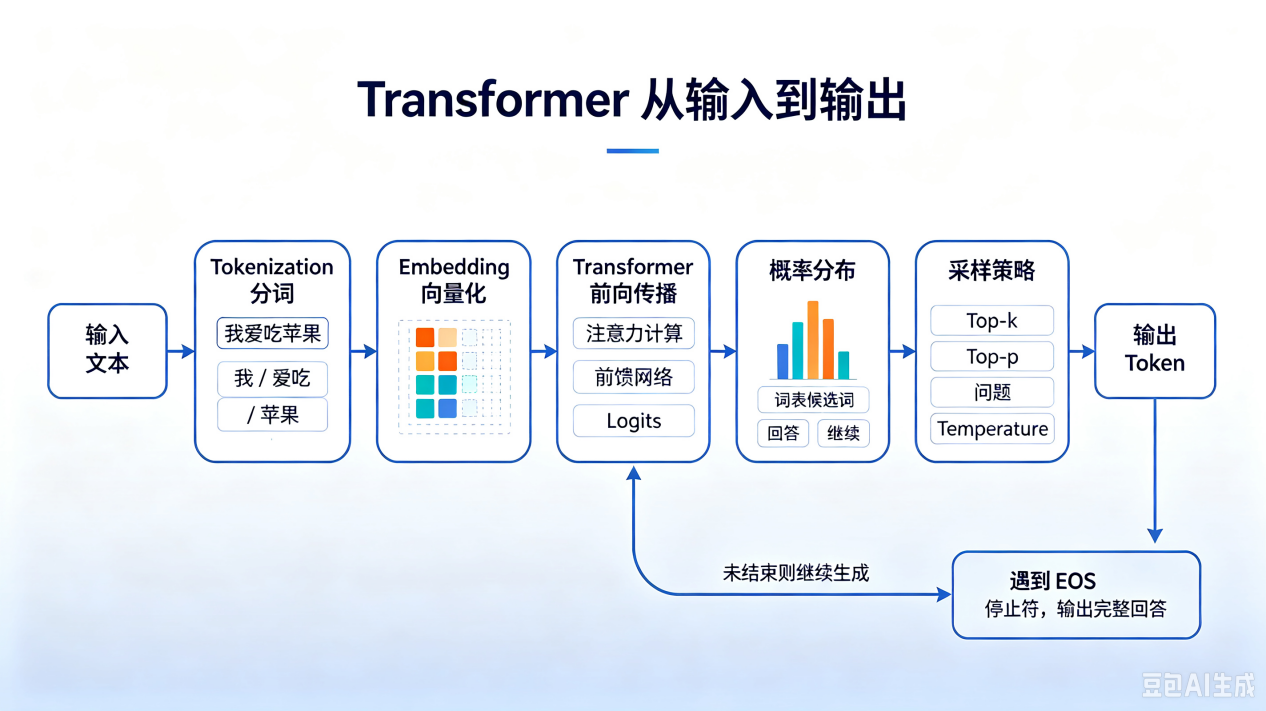
Tokenization:文本拆分,模型的最小识别单元Token
我们人类学习语言的过程也不是一上来就直接学句子的,要先识字,然后组词,最后才是造句。模型也是如此。最简单的方式就是"教"会模型认识所有的常见字,而模型和电脑一样只认识二进制数据。那直接使用现成的字符集不就行了?但是这种方式如果只训练常见字模型遇到没见过的字就懵了,最终的训练效果并不是很好。
基于"教模型认字"的思路,人们提出了Tokenization——我们这里不探讨这个词怎么翻译,暂且就用原词——将句子划分成Token:从大量的训练用文本内将文本划分成一个一个的小单元,每个小单元就是一个Token,所有的Token组成词表。直接使用字符集属于Tokenization中的一种方法。这一步和模型本体无关,只是为了产生一个词表而已。
Embedding:语义向量化,让模型读懂词语之间的关联
现在模型识字了,但依然不理解Token之间的联系,例如它知道有"苹果"和"香蕉",但是它不知道这两个东西都属于"水果"。为了解决这个问题,人们又提出了Embedding,将Token转换为向量。
在这里的向量是表示Token之间的"语义距离"的一种数据结构,可以用三维坐标系中的点来近似理解。像(X1, Y1, Z1)和(X2, Y2, Z2),X1与X2之差的绝对值越小就说明在X这个方向上两个点越近。
不过Embedding是由模型来完成的,向量的维度很大,且没人能解释每个维度的含义是什么。大部分语言类大模型把Embedding能力集成到了模型内部,另外也有专门的独立的Embedding模型,后者用于部分文生图等其他领域大模型作为理解人类语言的"翻译官"。
前向传播:计算概率分布,预测下一个生成字词
但是一段话可不能仅由一堆语义相近的字词组成啊,怎么让模型"学会说话"呢?不难想到我们小学时都做过的几种语文题:选词填空、续写句子等。
选词填空有一个标准答案,做错了老师会纠正我们。久而久之,我们就学会了什么词出现在什么句子里更合适。模型训练也是如此,大量的案例和一套确切的评分规则让模型也学会了什么Token出现在现有的Token序列后面更适合。
续写句子则没有标准答案,我们只能拿到半句话,要自己续写出完整的句子来。这就有点像我们调用模型了:我们给模型输入一段文字,最终要求生成一段回复。这个从输入流向输出的过程被称为前向传播。模型的前向传播先读取输入的向量序列,然后利用"学到"的规则判断词表中的每一个Token出现在下一位的概率。整个词表及Token出现的概率构成一个概率分布,在这个概率分布内随机采样出一个Token,这就是一次完整的前向传播。
前文没有提到为什么不把整个字符集都教给模型,原因是模型计算的概率分布会包含词表里的每个字符,如果词表太大这一步的计算量会十分庞大,而Top_k和Top_p的裁剪是在概率分布计算完成后才进行的,因此不会减少计算量。
停止符 EOS:控制 AI 结束生成的特殊标记
那么模型是怎么停止生成的呢?其实也十分简单,把句子的结束也作为一个Token放进词表就可以了,随后只需要检测到模型生成了代表结束的Token就停止生成。这也就解释了部分模型为什么可以支持终止符参数,这个参数不过是把代表结束的Token换成了你传入的Token而已。
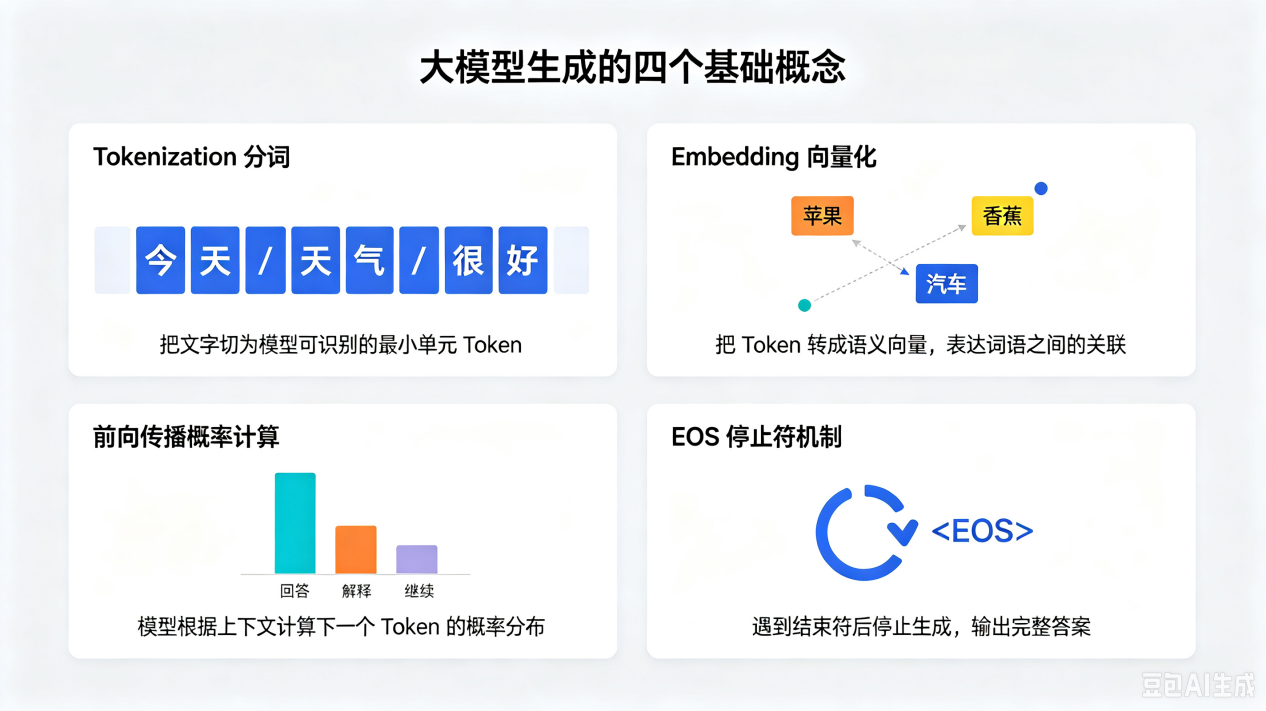
一段输入先被拆成Token序列,再转换为向量序列,经过模型的计算变成概率分布,从中采样出新Token再拼回向量序列末尾。一直重复这个过程直到生成结束符。这就是大模型把输入变成输出的完整循环。
在这个循环内,你传递给模型的参数(Temperature、Top-k 、Top-p等)都会影响最终生成的输出;MoE(混合专家模型)和KV-Cache(KV-缓存)默默帮你省着钱;RAG(检索增强生成检索了那些可能需要提供给模型的额外信息;MCP(模型上下文协议)为模型提供了"做事"的能力。
还有许许多多的配套技术让模型的能力越发强大,它们不是生成循环本身的一部分,但同样影响着模型的实际表现。