获取专属方案
400-029-6292

RAG:模型怎么“知道”它不知道的东西

发表时间:2026-09-03 15:36

在现在这个大模型遍地开花的情况下,我想大家至少都有一款自己常用的ai吧?不知道大家在使用的过程中有没有问过模型的“知识库截至时间”?而且很容易发现,发生在“知识库截至时间”之后的事件去问ai,它就会一本正经的胡说八道,或者干脆告诉你它不知道。部分ai提供“联网搜索”之类的功能,把它打开再问一次,就能看到ai搜索了一批网站,这次的回复就准确多了。这是为什么呢?

什么是RAG,它能做什么?

我们都知道,模型是“训练”出来的,通俗来讲“训练”就相当于我们人类的“学习”,模型的“知识库截至时间”相当于我们的“学历”。问模型知识库截至时间之后发生的事情就像问一个小学生初中的知识点,胡编乱造和不知道是完全正常的。打开“联网搜索”功能后就相当于允许模型去查资料翻小抄,回答的准确性就上来了。联网搜索是一种“从模型的‘大脑’外部获取知识的手段”,属于RAG(检索增强生成)的一种方式。
RAG的作用就仅限于此了吗?当然不是,大模型的架构被有意设计为“插件式”的,模型本身是核心,其他功能都是为核心提供扩展的“插件”——包括RAG。这意味着模型训练时完全不需要考虑RAG知识库怎么组建,由谁组建;任何人都可以制作自己私有的知识库;知识库可以在多个模型间公用,可以分享给其他人用……
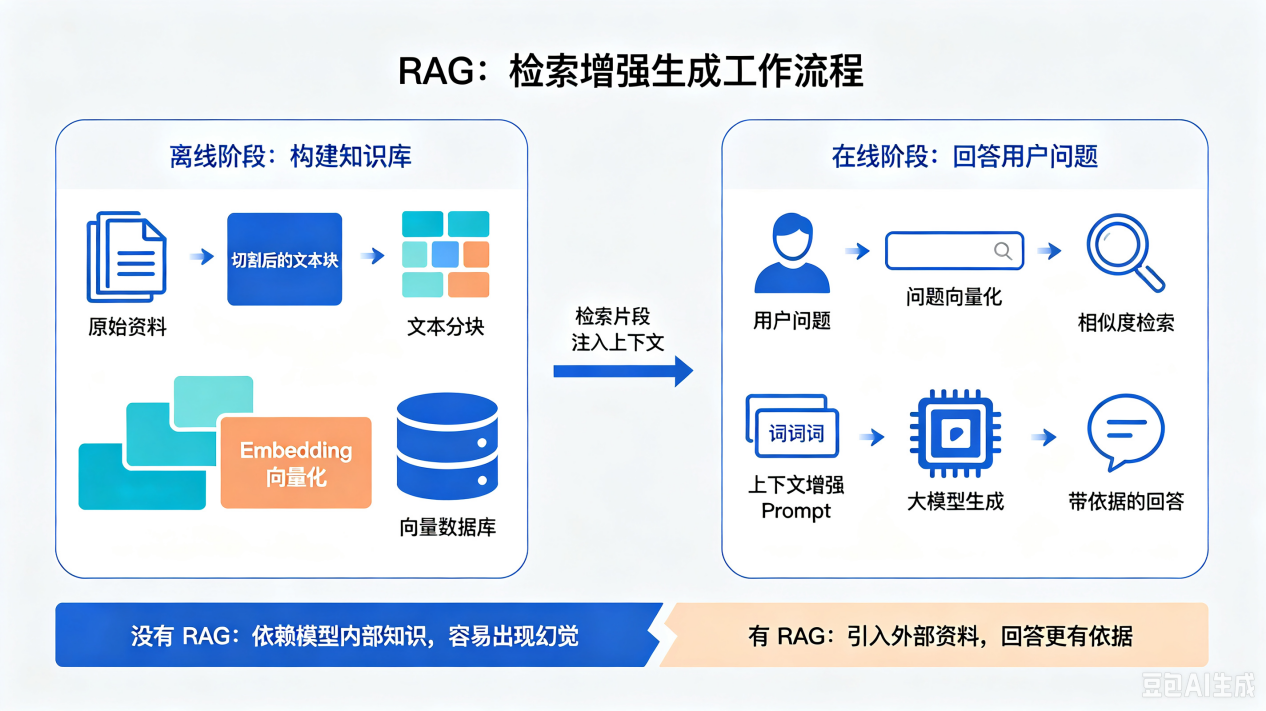
没有RAG,我们使用模型是简单的“用户→模型”,RAG插入了这个调用链将其变成了“用户→RAG→模型”,RAG的存在与否不会影响用户和模型的行为,RAG可以随意添加、删除、更新或替换。
构建RAG知识库需要将原始参考资料切分成小块,向量化后以键值对(“向量:资料”)的形式存储到专门的向量数据库。在使用阶段,RAG包括“检索”、“增强”、“生成”三个步骤:检索是将用户的输入也转换为向量,通过算法选数据库中最“相似”的一批向量;增强是将搜索到的文本块与提示词结合起来,得到一份更完整的提示词;生成是将完整提示词发送给模型以获取最终回答。

拆解 RAG 完整技术流程

上文大致解释了一下RAG的作用和做了什么,接下来我们来深入一点,看看它是怎么做的,以及为什么要这么做。

构建知识库:文档分块与向量化预处理

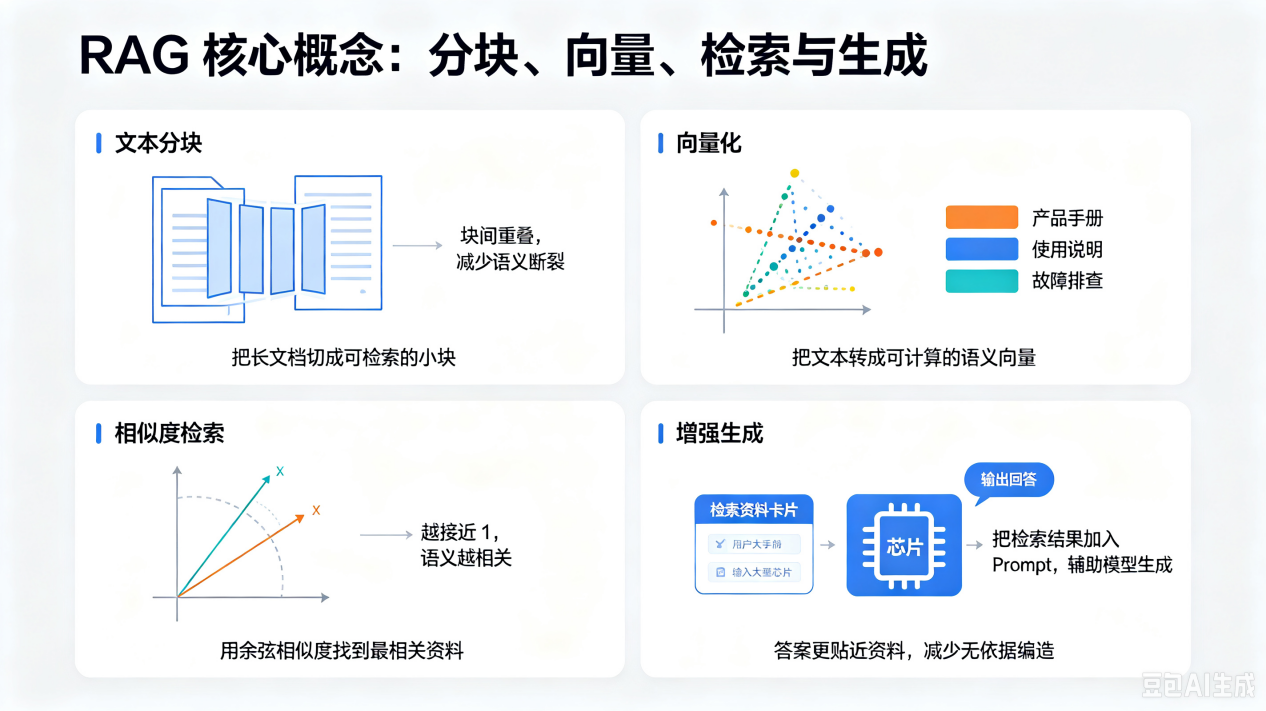
构建知识库时要分块,但是分块过大则每一块文本的语义模糊,难以正确匹配,且长文本会占据较长上下文,消耗大量token。同时这也是为什么必须分块,我想没人愿意看到自己简单的提问导致一份几万字的文档被整篇发送给模型。而分块过细会导致每次检索能提供的分块数量少,而且语义没有宽泛性容易匹配不到。
目前的常见做法是按照段落(换行符)或按照句号划分,又或者按照指定文本块大小(这时用token数衡量文本块大小而不是用字符数),如512token为一块进行划分。按固定大小划分时为了确保整段文字的语义连贯性,通常两个相邻文本块之间会有部分重叠内容。

RAG检索:靠余弦相似度找到相关资料

RAG的检索阶段,对于文本文档最常用的判断相似程度的方法是计算其余弦相似度。
首先什么是向量呢?借助二维直角坐标系来理解,向量表示为(x,y)这样的组合,其中每一个字母都代表一个数字。向量可以想象成从(0,0)点出发指向(x,y)点的一根箭头。
余弦相似度就是两个向量之间夹角(两个角里更小的那个)的大小。余弦相似度取值在[-1,1],其数值越接近1说明两个向量越相似(夹角越小)。
每次检索也不是拿着根据用户输入算出来的查询向量去数据库里一条一条比对,而是通过一些快速临近算法快速定位查询向量的大致范围,然后一层层缩小这个范围最终完成匹配。
最终匹配到的是向量没错,但向量数据库存放的是键值对,类似“apple:苹果”这样,拿着向量可以很轻松得知其对应的原始文本块,就像拿着apple去词汇表查询它的中文翻译一样。

RAG增强:把检索内容注入提示词

在增强阶段,检索阶段检索出来的资料文本块会按照一定的策略注入到上下文中。最常见的策略有追加到系统提示词后和追加到用户最新一轮输入的末尾或开头。
前者会极大程度地破坏缓存命中,注入的文本过长还会导致模型对系统提示词的执行出现偏差。不过这种方式会让模型把资料当成背景知识,对资料的参考程度最高。
后者几乎不会破坏缓存命中,模型明确知道资料是用户提供的,但注入的文本过长会影响模型对用户本次提问的理解。这种方式模型对资料的参考程度会低一点。

RAG生成:交给大模型输出最终答案

最后的生成阶段和我们不使用RAG调用模型是一样的,将增强后的上下文发送给模型获取最终的参考了资料的回复。

RAG的意义:低成本便捷扩展模型知识

模型是个静态的文件,从训练结束的那一刻它的知识就被“冻结”了,之后再问它任何它没学习过的知识就像是让小学生做初中题,一通乱做完全可以理解。RAG则提供了另一种方式,连同资料和问题一同发送给模型,让模型“有理可依”进而规范它的回复。
以往人们想要让模型“多懂一点”得进行模型微调,甚至重新训练。这些任务不仅花费时间和算力,对训练数据的质量和数量还都有一定的要求,最终结果还可能不尽人意。而有了RAG后只需要准备好文档,构建出向量化知识库即可,模型本身的实力不变,额外的知识还可以随时调整。这无论对个人还是企业都省出了一笔可观的开销。