浆液浓度补偿模型训练对比报告发表时间:2026-09-07 17:06 一、代码训练及目标本次实验使用 compare_tslib_models.py 训练脚本,在 realistic_slurry_data.csv(40 万条仿真数据)上完成了 DLinear、TimeMixer、Transformer+LSTM 三种时序模型的训练与对比。 实验目标是从三个模型中选出最优模型,用于后续生产环境部署。 训练配置统一为:窗口长度 50,d_model=128,num_layers=2,MAE 损失函数,学习率 5e-4,batch_size=1024,启用 delta_mode 和 lag 特征。 二、训练结果按验证集达标率排序,结果如下:
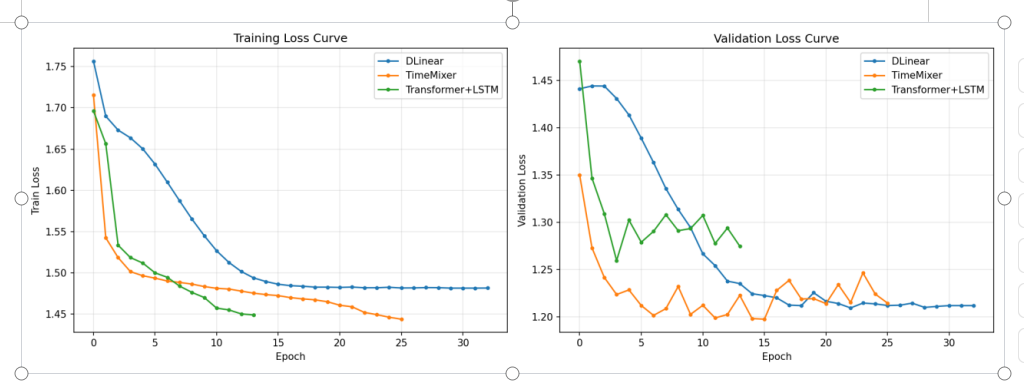
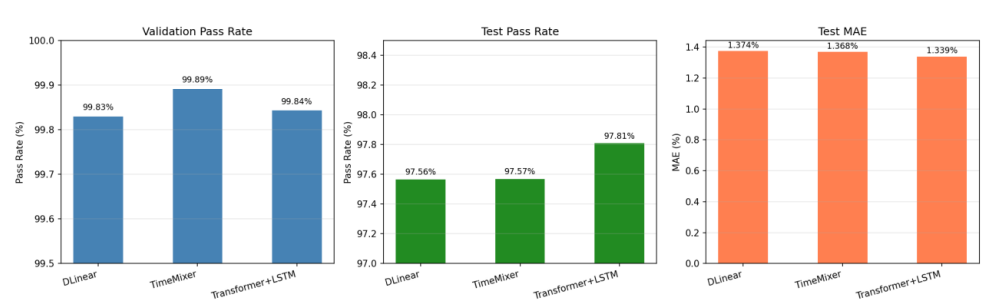
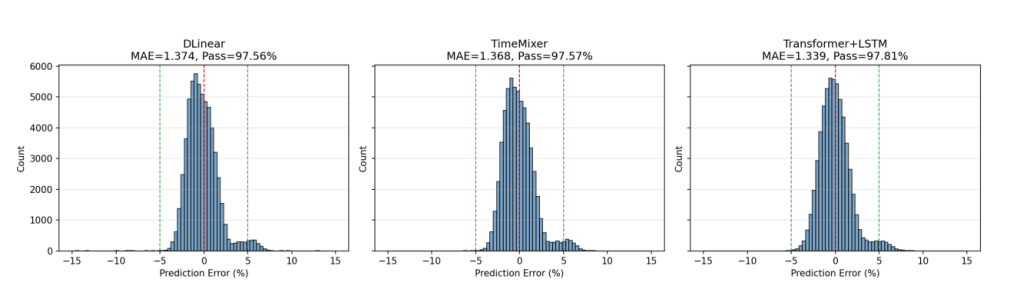
三、训练过程可视化下图展示了三个模型在训练过程中的训练 loss 和验证 loss 变化曲线。数据来源:results_remote/train_all_models.log 和 train_three_models.log。 四、指标对比图表下图从左到右依次为:验证达标率、测试达标率、测试 MAE 的柱状图对比。 五、评价指标解释 1. 验证达标率(Validation Pass Rate)定义:在验证集上,模型预测浓度与人工化验浓度的绝对误差不超过 5% 的样本所占比例。 作用:验证集用于模型选择,是训练过程中挑选最优模型的依据。 本次结果:TimeMixer 验证达标率最高(99.89%)。 2. 测试达标率(Test Pass Rate)定义:在测试集上,模型预测浓度与人工化验浓度的绝对误差不超过 5% 的样本所占比例。 作用:测试集是完全未参与训练和模型选择的数据,用于评估最终模型的真实泛化能力。 本次结果:Transformer+LSTM 测试达标率最高(97.81%),是生产部署的核心参考指标。 3. 测试 MAE(Test Mean Absolute Error)定义:在测试集上,模型预测浓度与人工化验浓度的平均绝对误差。 作用:MAE 反映模型预测的平均偏差大小,MAE 越小表示预测越接近真实值。 本次结果:Transformer+LSTM 测试 MAE 最小(1.339%)。 六、误差分布与预测效果下图展示了三个模型在测试集上的预测误差分布。红色虚线为 0 误差,绿色虚线为 ±5% 达标边界。数据来源:results_remote/*_test_preds.csv。
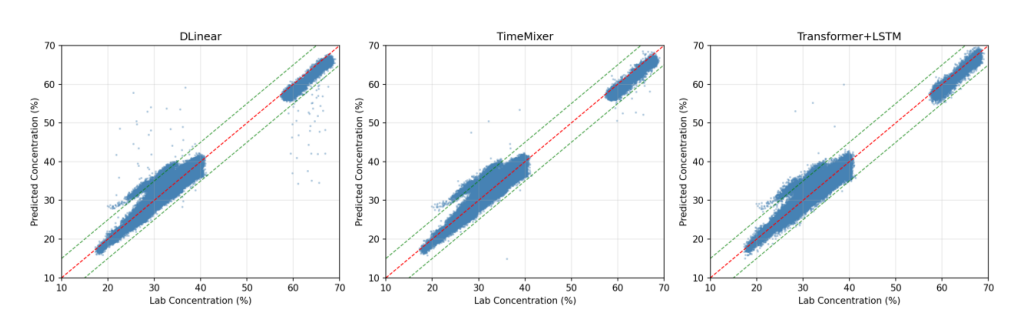
下图展示了模型预测值与真实化验值的散点图。红色对角线为完美预测,绿色虚线为±5% 误差边界。
七、排名依据说明 排名依据验证集达标率,是机器学习中模型选型的标准做法。验证集用于模型选择,测试集用于最终评估。如果用测试集来排名,会导致信息泄露,测试结果不再客观。 本次三个模型在验证集和测试集上表现接近,差距均在 0.3% 以内,属于正常波动范围。 八、模型选型与部署结论根据 compare_tslib_models.py 的自动选型逻辑(按验证集达标率排序),TimeMixer 被选为验证集最优模型。 但从测试集实际表现来看,Transformer+LSTM 的测试达标率(97.81%)和测试 MAE(1.339%)均为最优。 综合考虑模型选择标准、测试集性能和部署可行性,本次选择 Transformer+LSTM 作为生产部署模型,原因如下: 1. 测试集达标率最高,测试 MAE 最小 2. production_inference.py 已内嵌 Transformer+LSTM,可直接部署 3. TimeMixer 依赖 TSLib 多个模块,生产环境内嵌成本较高 九、后续计划1. 在 production_inference.py 中加入 EMA 在线偏置修正,每 15 分钟用人工化验浓度更新 bias_ema。 2. 持续收集带标签的生产数据,用于后续周期离线 fine-tune。 3. 监控不同温度下的预测误差,必要时用跨温度数据重新训练,提升季节适应性。 十、数据来源说明报告中所有图表均基于真实训练日志和预测结果生成。 • 训练曲线数据来源:results_remote/train_all_models.log、results_remote/train_three_models.log • 指标数据与预测结果来源:results_remote/model_comparison_results.csv、results_remote/*_test_preds.csv |
核心与技术平台
产品与解决方案